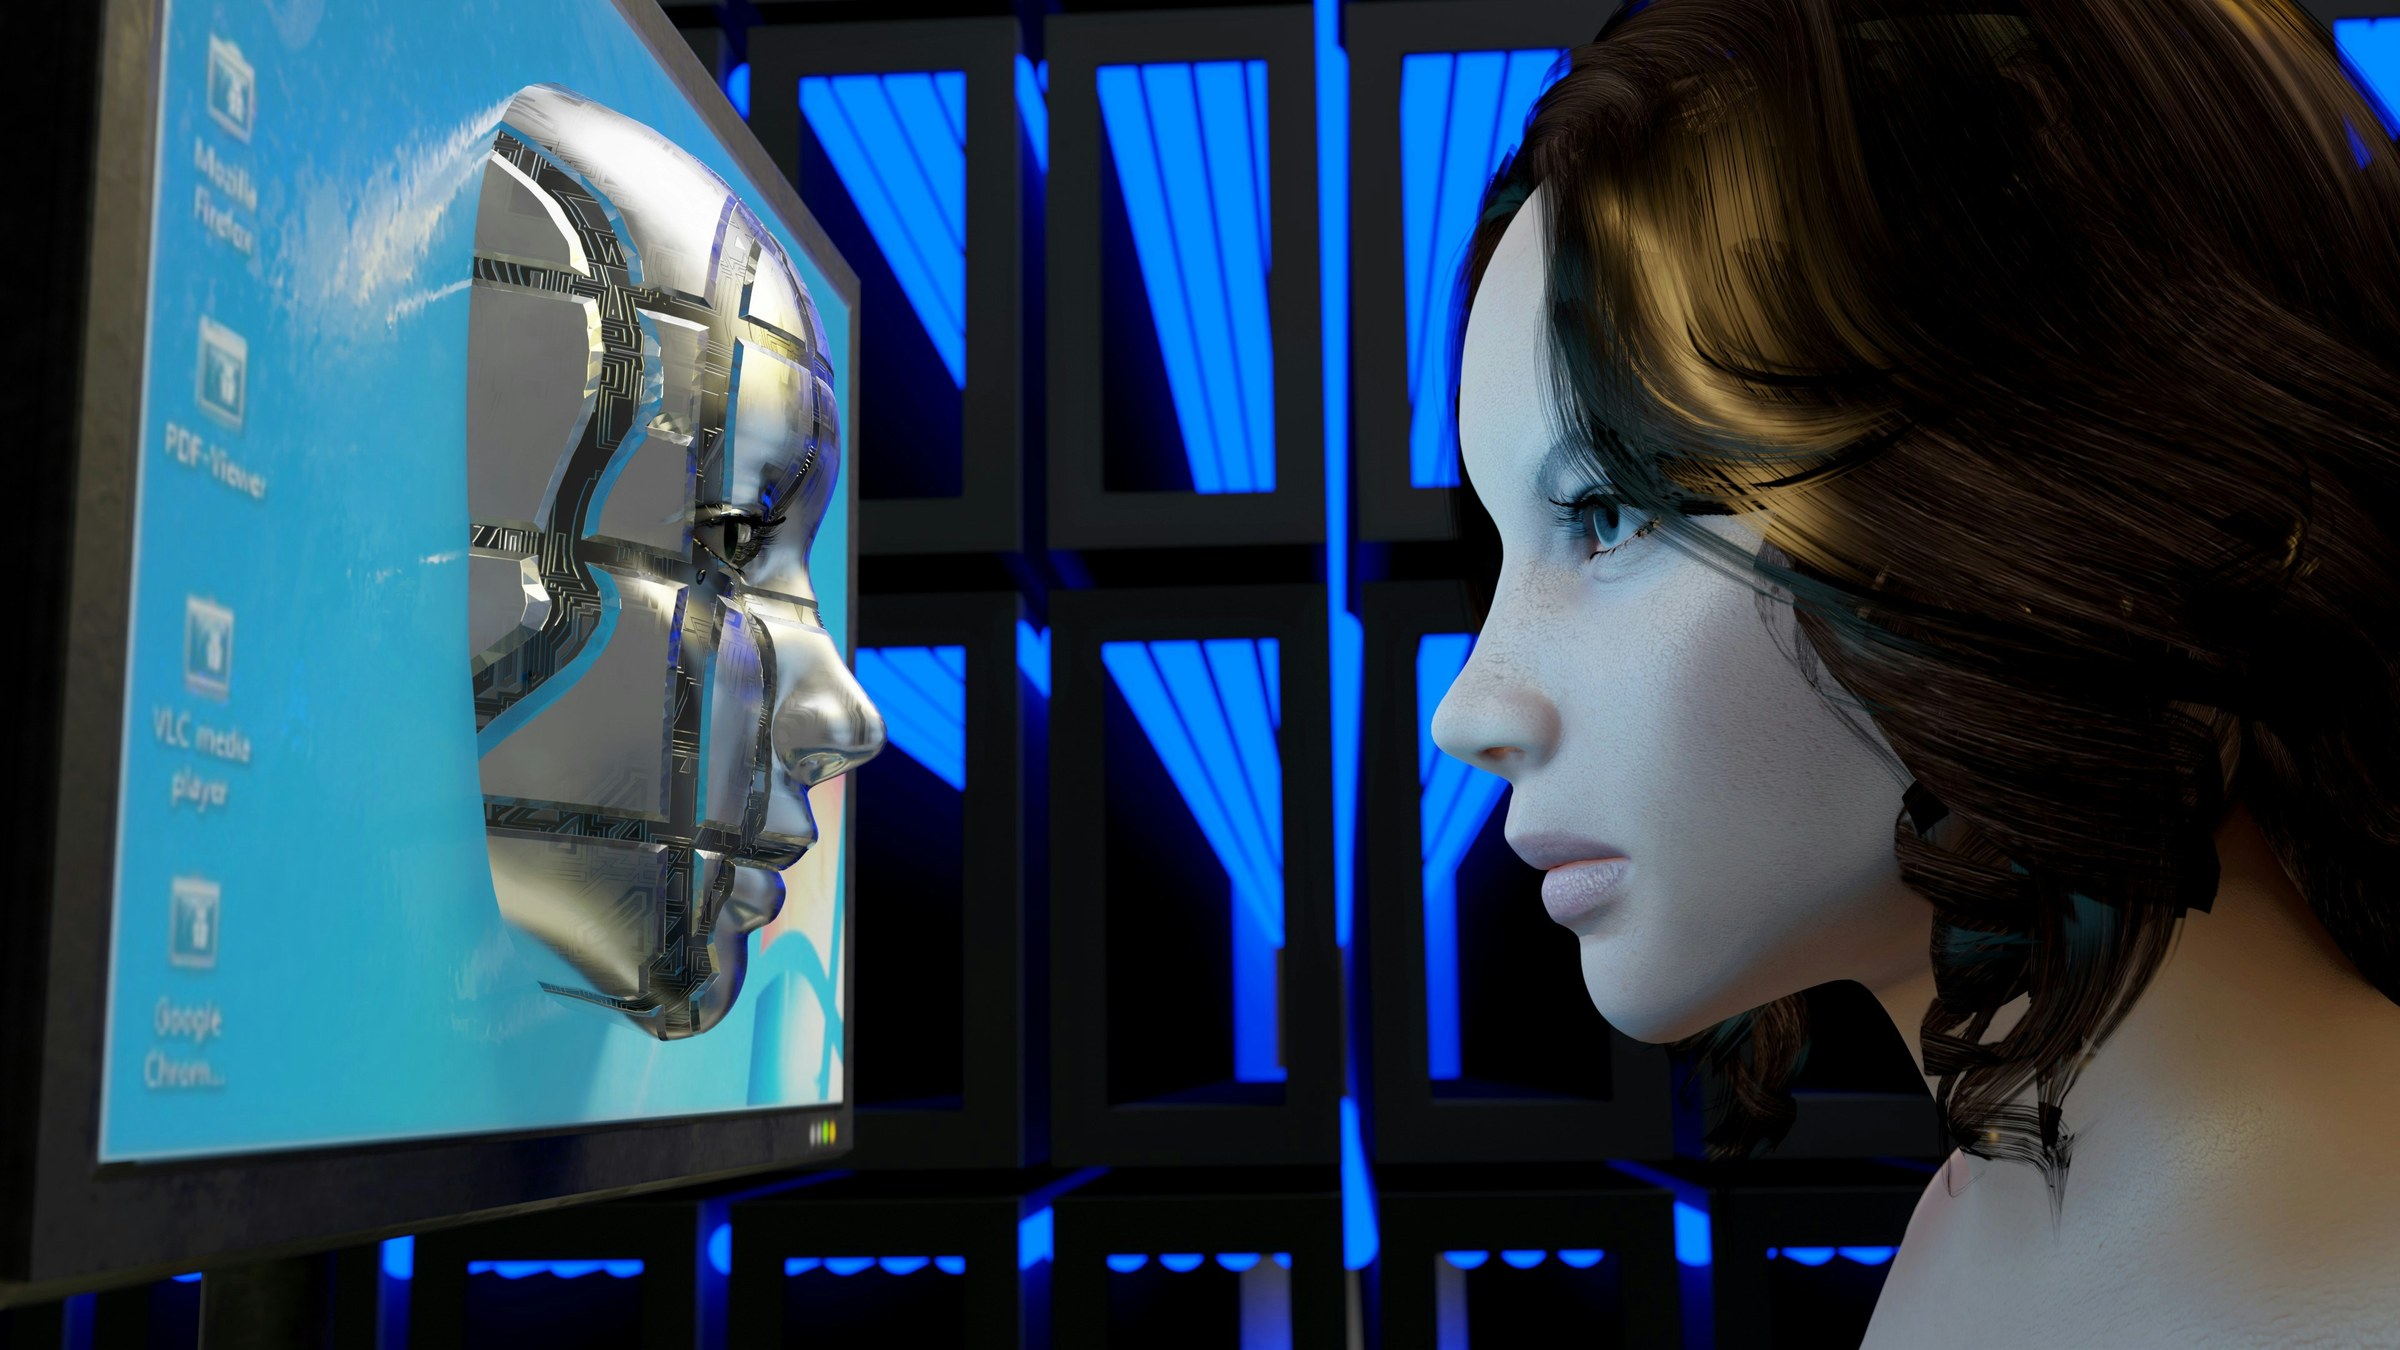
 Visuel de présentation de Dessa, le modèle vocal de Block, publié par Notebookcheck
Block dévoile Dessa, une IA vocale sans texte Le modèle de Jack Dorsey apprend sur la parole seule
Block, la société de Jack Dorsey, présente Dessa, un modèle voix-à-voix entraîné sans texte écrit, réservé pour l'instant à des chercheurs en sécurité.
Par La rédaction
Pourquoi ça compte
Block, la maison mère de Square et Cash App, a présenté Dessa, un modèle d'IA vocale qui écoute et parle en même temps. D'après l'annonce relayée par Notebookcheck, il a été entraîné de zéro sur des enregistrements de conversations humaines, sans texte écrit ni modèle de langage préentraîné. Pour une marque ou une agence qui travaille la voix (assistant, service client, spot interactif), l'enjeu se lit dans l'argument de vente : une voix de synthèse qui sonne juste parce qu'elle n'est plus fabriquée à partir d'un texte. Block affirme que la chaîne habituelle, de la parole au texte puis du texte à la parole, perd ce que la voix porte : hésitation, ironie, rire, fatigue. La suite est mince pour le public. Dessa n'est pas disponible : Block invite un petit groupe de chercheurs en sécurité et ouvre une liste d'attente pour les autres, selon Notebookcheck.
Les faits
- Annonceur
- Block
- Médias
- Blog et site de démonstration de Block
- Date
- 23 octobre 2026
- Marché
- États-Unis
Le sujet est apparu en français le 23 octobre sur Brief IA, puis a été repris le 24 par 3DNews, Notebookcheck, Gizmodo en espagnol et Mashable, et le 25 par IT之家. La rédaction n'a pas pu ouvrir la page d'origine de Block : les faits ci-dessous viennent de ces relais, qui citent l'annonce de la société.
Dessa est décrit comme un modèle full-duplex de parole à parole : il écoute et parle simultanément, ce qui lui permet d'interrompre, d'acquiescer et de réagir sans attendre la fin de la phrase de l'interlocuteur (Notebookcheck). Block dit qu'il n'utilise ni texte écrit ni modèle de langage préentraîné, donc que sa connaissance de la langue, des faits et des usages de conversation vient de l'audio seul (Notebookcheck).
Block justifie le projet par une image : les jeunes enfants apprennent à parler sans avoir vu un mot écrit, et l'équipe voulait savoir si un modèle pouvait en faire autant. Sa réponse, citée par 3DNews en russe, tient en deux phrases : c'est possible, et c'est très difficile. Trois motivations sont citées : la curiosité, une meilleure compréhension entre les gens, la sécurité (3DNews).
Sur la sécurité, l'équipe écrit que l'IA devient plus puissante et plus autonome tout en restant presque sourde aux émotions de la voix. Elle prend l'exemple d'une personne en grande douleur que l'IA vocale ne remarquerait pas et à qui elle continuerait de répondre normalement. Dessa serait un pas vers la correction de ce défaut (Brief IA, 3DNews). Selon IT之家, les chercheurs invités testeront surtout des scénarios où un agent vocal tromperait un humain.
Côté matériel, Block affirme avoir entraîné Dessa sur un seul système Nvidia GB200 NVL72, soit 72 GPU Blackwell. Le modèle tournerait en local sur un MacBook Pro équipé d'une puce M4 Max ou mieux, plus vite que le temps réel, donc sans pause perceptible (Notebookcheck).
Les démonstrations publiées par Block montrent un modèle qui rit au milieu d'une phrase, hausse la voix quand on lui demande de parler plus fort et finit la phrase d'une personne qui cherche un titre de film (Notebookcheck). Dans une scène, il réagit avec une émotion proche des larmes à quelqu'un qui dit l'avoir emmené à Paris (3DNews). Dans une autre, il dialogue avec GPT-Live-1, le modèle vocal d'OpenAI, et sonne plus naturel selon Block (Notebookcheck, 3DNews). Les extraits ne sont pas tous flatteurs : Ragavan Thurairatnam, qui dirige le projet, a publié un échange où Dessa prend d'abord son interlocuteur pour un certain Ronaldo, et une discussion sur Christopher Nolan où il dérive vers les Superman de Bryan Singer (Brief IA).
Le contexte
La voix est devenue un terrain de la course aux modèles. IT之家 rappelle que GPT-Live d'OpenAI, lancé plus tôt dans l'année, est lui aussi full-duplex, et que la plupart des modèles vocaux s'appuient sur un grand modèle de langage pour aller chercher leurs connaissances. Block revendique l'inverse : Dessa tire son savoir des conversations qui l'ont formé.
L'argument touche directement la création. Selon IT之家, des modèles comme ElevenLabs v4 ou Fish Audio Drama 3 pilotent l'émotion avec des balises dans le texte, ce qui fait de l'émotion une consigne de mise en scène plus qu'un comportement. Block dit que l'expression des émotions est native chez Dessa, tout en laissant ouverte, note IT之家, la question de savoir si une forme de balisage existe en dessous.
Block n'est pas un laboratoire de voix. IT之家 rappelle que son métier est la finance pour les petits commerçants et que Square utilise déjà l'IA vocale pour prendre des commandes. Un modèle qui tourne sur l'appareil, sans serveur, ferait baisser le coût de produits vocaux pour les marchands et le grand public, estime le site chinois.
Ce que ça change
- La voix comme argument de marque. Si le naturel vient de l'entraînement et non d'un script, une marque peut défendre une voix d'assistant qui hésite, rit et se corrige. Le choix créatif devient celui du degré de défaut accepté : les démonstrations de Block gardent leurs erreurs visibles.
- Le local comme promesse. Un modèle qui tourne sur un portable évite l'envoi de la voix vers un serveur. Block n'a pas détaillé cet argument, mais la rédaction y voit le premier à tester pour un service client ou de santé, une fois le modèle ouvert.
- L'émotion perçue, pas seulement jouée. Block insiste sur l'écoute de l'émotion, pas seulement sur sa synthèse. Pour un service client, la valeur serait de repérer la détresse ou l'agacement dans la voix, ce que les chaînes passant par le texte ne voient pas, selon l'équipe.
Ailleurs
Le modèle vocal d'OpenAI sert de point de comparaison dans les démonstrations de Block, qui le fait dialoguer avec Dessa. Selon IT之家, GPT-Live est full-duplex comme Dessa mais s'appuie sur un modèle de langage pour ses connaissances.
IT之家 cite ElevenLabs v4 et Fish Audio Drama 3 parmi les modèles qui contrôlent l'émotion par des balises, l'approche à laquelle Block oppose l'émotion native de Dessa.
Sources
- Brief IA : Block lance Dessa, modèle voix-à-voix entraîné sur parole FR, 23 octobre 2026
- 3DNews : Основатель Twitter представил голосовой ИИ, обученный с нуля только на человеческой речи RU, 24 octobre 2026
- Notebookcheck : Jack Dorsey's new AI never read a single word, yet it can hold disturbingly human conversations EN, 24 octobre 2026
- IT之家 : Block 推出全双工 AI 语音模型 Dessa CN, 25 octobre 2026
- Gizmodo en español : ¡No lo podrás creer! Escucha las inquietantes voces prácticamente humanas de Dessa ES, 24 octobre 2026
Toutes les sources (6)
- Mashable : Block's latest AI model Dessa was trained entirely on human speech EN, 24 octobre 2026
Cités dans l’article
Réagir
Les réponses des lecteurs
À propos de « Block dévoile Dessa, une IA vocale sans texte »
Pas encore de réponse publiée. Les réponses s’ouvriront ici, relues par la rédaction.
Rien n’est envoyé tant que vous n’appuyez pas sur Envoyer