 Illustration NVIDIA d'un modèle d'IA central relié à du code, des graphiques, des données de mémo de crédit et de l'analyse vidéo
NVIDIA ouvre Nemotron 3.5 Super VL Un modèle à 120 milliards de paramètres et deux Bolt locaux
NVIDIA a publié le 15 octobre Nemotron 3.5 Super VL, un modèle ouvert de 120 milliards de paramètres pour agents d'entreprise, avec deux modèles Bolt conçus pour tourner en local.
Par La rédaction
Pourquoi ça compte
NVIDIA a publié le 15 octobre 2026 Nemotron 3.5 Super VL, un modèle ouvert de 120 milliards de paramètres qui comprend le texte, les images, les tableaux et les PDF. Il est présenté comme le plus rapide de sa catégorie pour les agents qui travaillent en continu. Deux modèles plus petits, Bolt 74B-A9B 24GB et Bolt E4B 4GB, l'accompagnent pour les machines locales. Pour une marque ou une agence, l'intérêt tient moins au score qu'au positionnement : NVIDIA vend un modèle que l'on adapte à ses propres données et que l'on fait tourner chez soi, avec des clients nommés pour le prouver. Tous les chiffres de performance cités ici sont ceux de NVIDIA ou de ses partenaires.
Les faits
- Annonceur
- NVIDIA
- Production
- Développé avec la Nemotron Coalition (Mistral AI, Thinking Machines Lab, Perplexity, Black Forest Labs, selon The Decoder)
- Médias
- Hugging Face, OpenRouter, communauté ModelScope, NVIDIA NIM
- Date
- 15 octobre 2026
- Marché
- Mondial
Le 15 octobre 2026, NVIDIA a publié Nemotron 3.5 Super VL, qu'elle décrit comme un modèle ouvert de 120 milliards de paramètres offrant l'exécution de tâches la plus rapide et la meilleure précision pour des agents spécialisés qui fonctionnent en continu. Deux modèles pour l'edge sortent avec lui : Bolt 74B-A9B 24GB et Bolt E4B 4GB. Super VL et Bolt 74B-A9B sont disponibles tout de suite, Bolt E4B à partir du 23 octobre.
Selon le blog technique de NVIDIA, Super VL est un modèle à mélange d'experts : il active 12 milliards de paramètres par token. Il a été distillé de Nemotron 3 Ultra, le plus grand modèle de raisonnement de la marque, et vise une précision comparable avec environ un cinquième des paramètres. Sur un seul GPU, NVIDIA annonce jusqu'à cinq fois le débit des modèles ouverts de taille voisine sur des tâches d'agent, en citant le classement d'Artificial Analysis. Sur les évaluations de comportement Hermes et LangChain, il dépasse Ultra, toujours selon NVIDIA. Côté vision, il obtient 80,8 % sur CharXiv, un test de lecture de graphiques, contre 63 % pour Nemotron 3 Nano Omni.
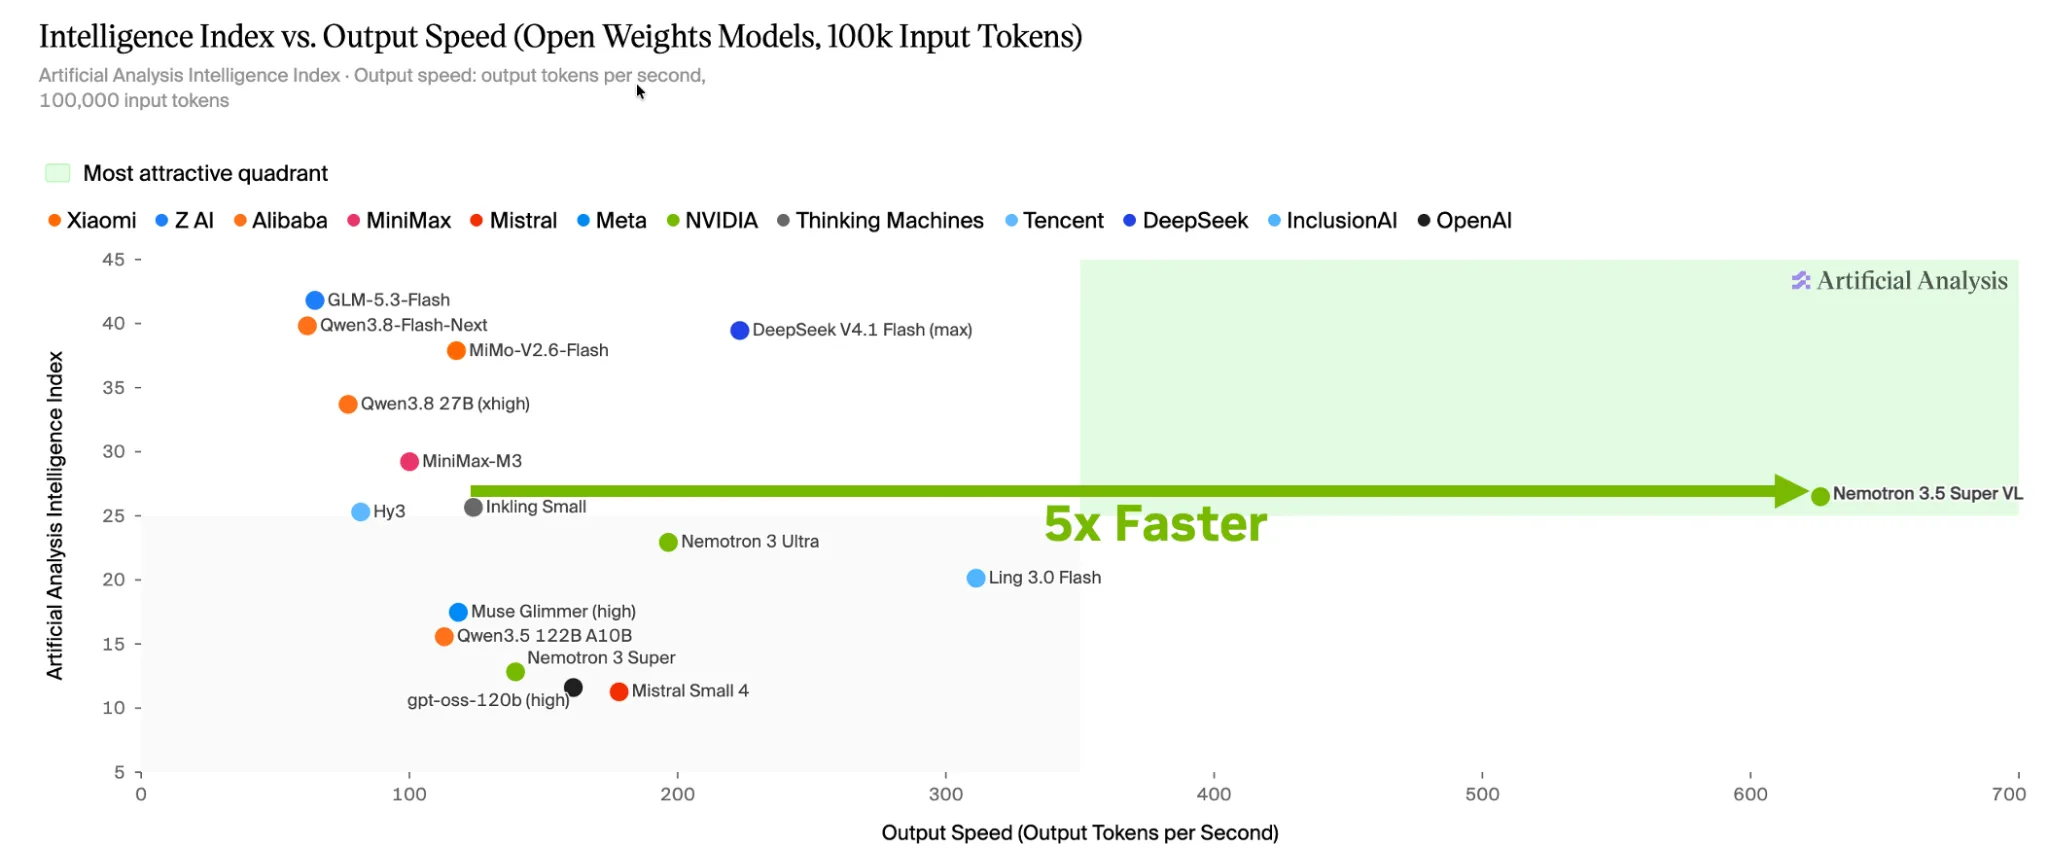 Graphique NVIDIA comparant le débit de Nemotron 3.5 Super VL à d'autres modèles ouverts
Les deux Bolt sont pensés pour le poste de travail. Le 74B-A9B active 9 de ses 74 milliards de paramètres et, grâce à une quantification native sur 2 bits, tient dans 24 Go de mémoire, ce qui lui permet de tourner à côté d'autres applications sur NVIDIA RTX ou DGX Spark. NVIDIA le range premier modèle ouvert de sa catégorie sur PinchBench et deuxième sur BrowseComp. Le E4B 4GB cible les assistants vocaux locaux, les personnages interactifs et les interfaces embarquées sur GeForce RTX, Jetson et DGX Spark.
NVIDIA met en avant des dizaines d'organisations qui post-entraînent Super VL sur leurs données. Scale AI l'a adapté à l'agent de crédit fournisseurs de Skydance, avec un coût d'inférence annoncé en baisse d'un facteur 40 et une latence divisée par 5. AI21 et Alice l'ont tourné vers l'analyse de menaces, pour une précision en hausse de 41 %. EY (due diligence en fusions-acquisitions), Hebbia (contrats de crédit), Ramp (documents financiers), Lila Sciences, R1 (remboursements médicaux) et Salesforce (workflows gouvernementaux) figurent aussi dans la liste.
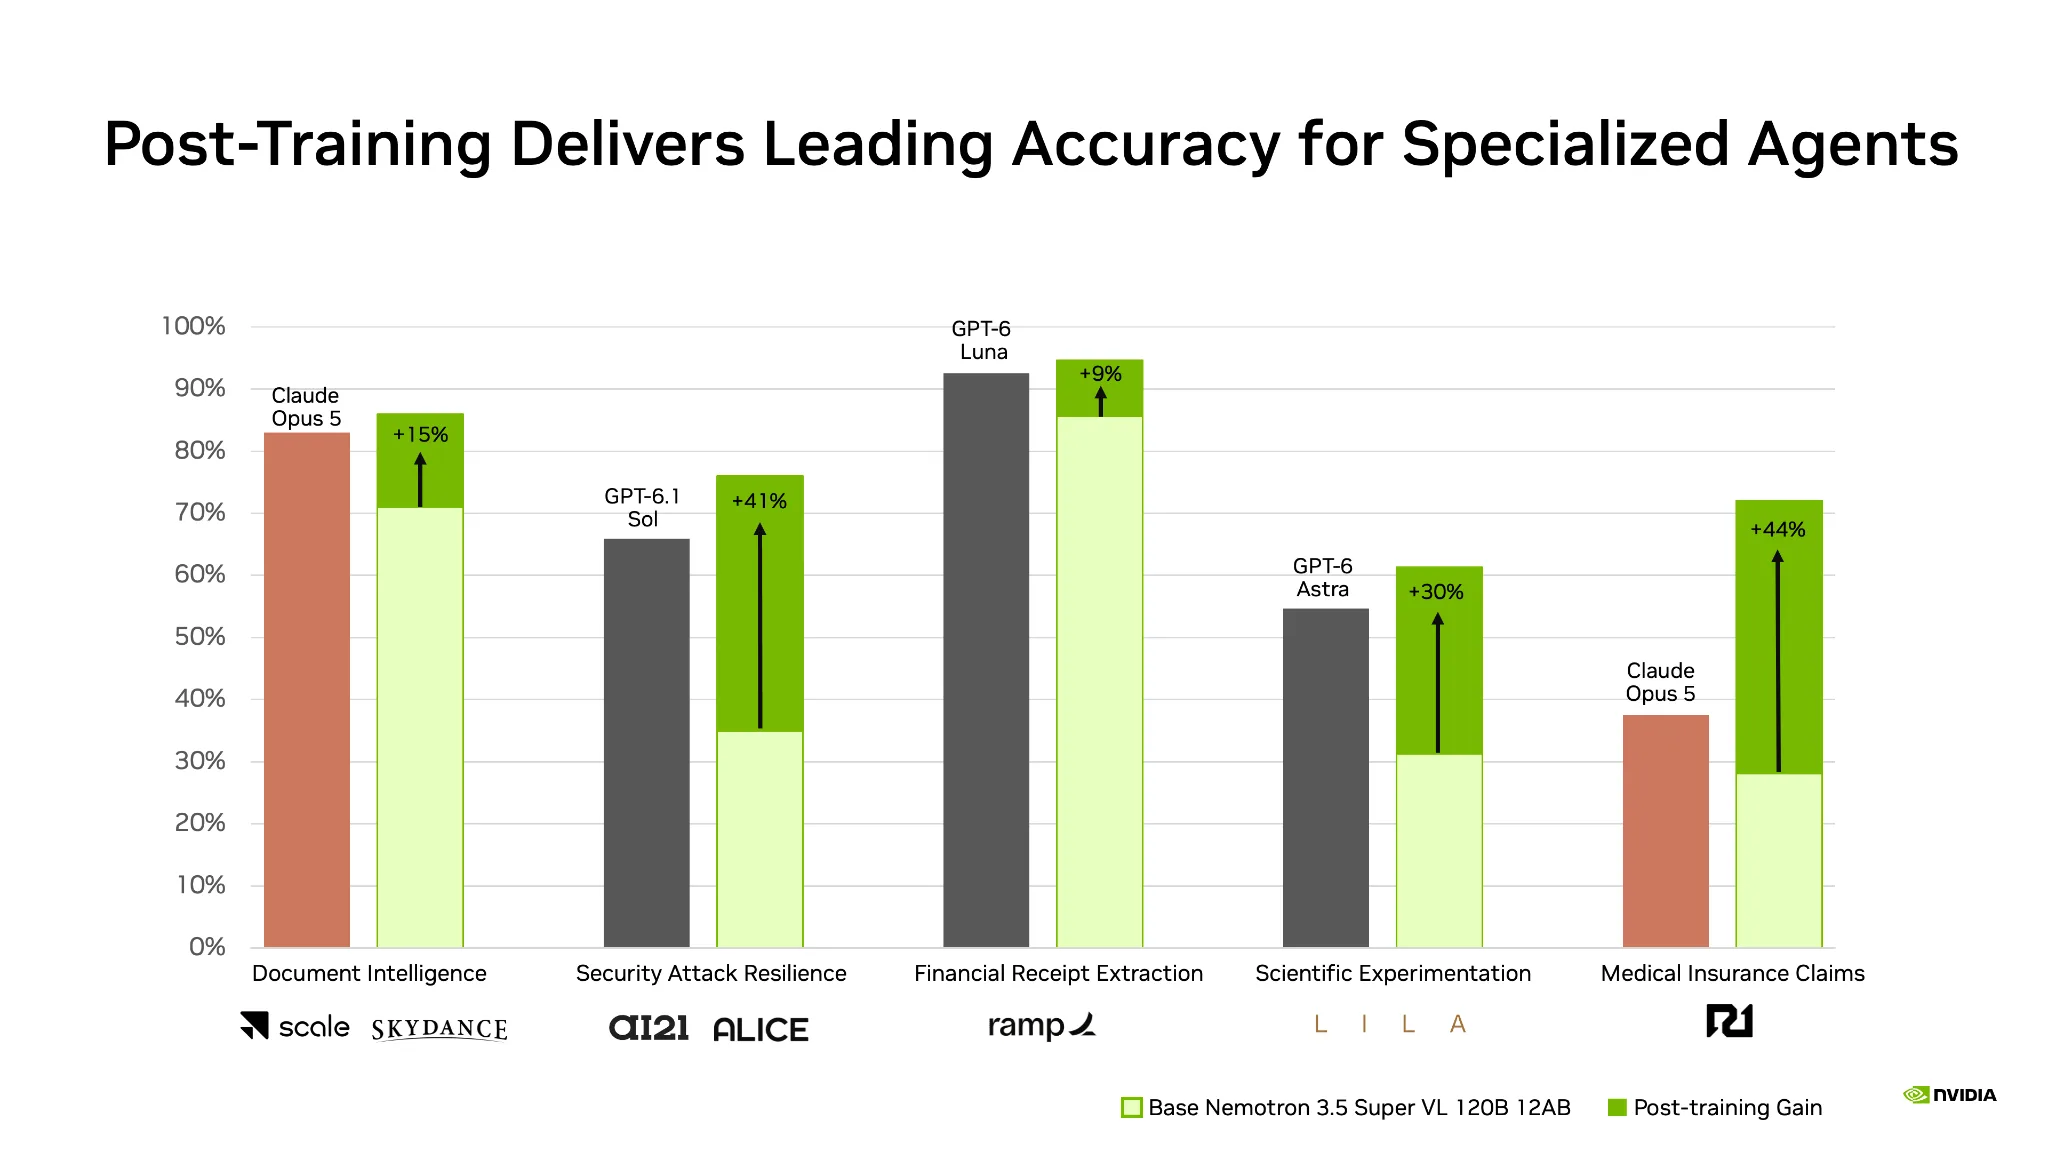 Graphique NVIDIA des performances de Nemotron 3.5 Super VL post-entraîné par secteur
NVIDIA publie les poids en version de base, post-entraînée et compressée en 4 bits, avec les jeux de données, les recettes d'entraînement et les environnements d'apprentissage par renforcement, ce qui est plus que ce que livrent la plupart des modèles à poids ouverts, note The Decoder. Le modèle est empaqueté en microservice NIM, mis à jour toutes les deux semaines. Sous Dynamo, le logiciel d'inférence de NVIDIA, il sert jusqu'à huit fois plus d'utilisateurs avec une latence au premier token réduite de 85 %, mesure faite sur 16 GPU B200.
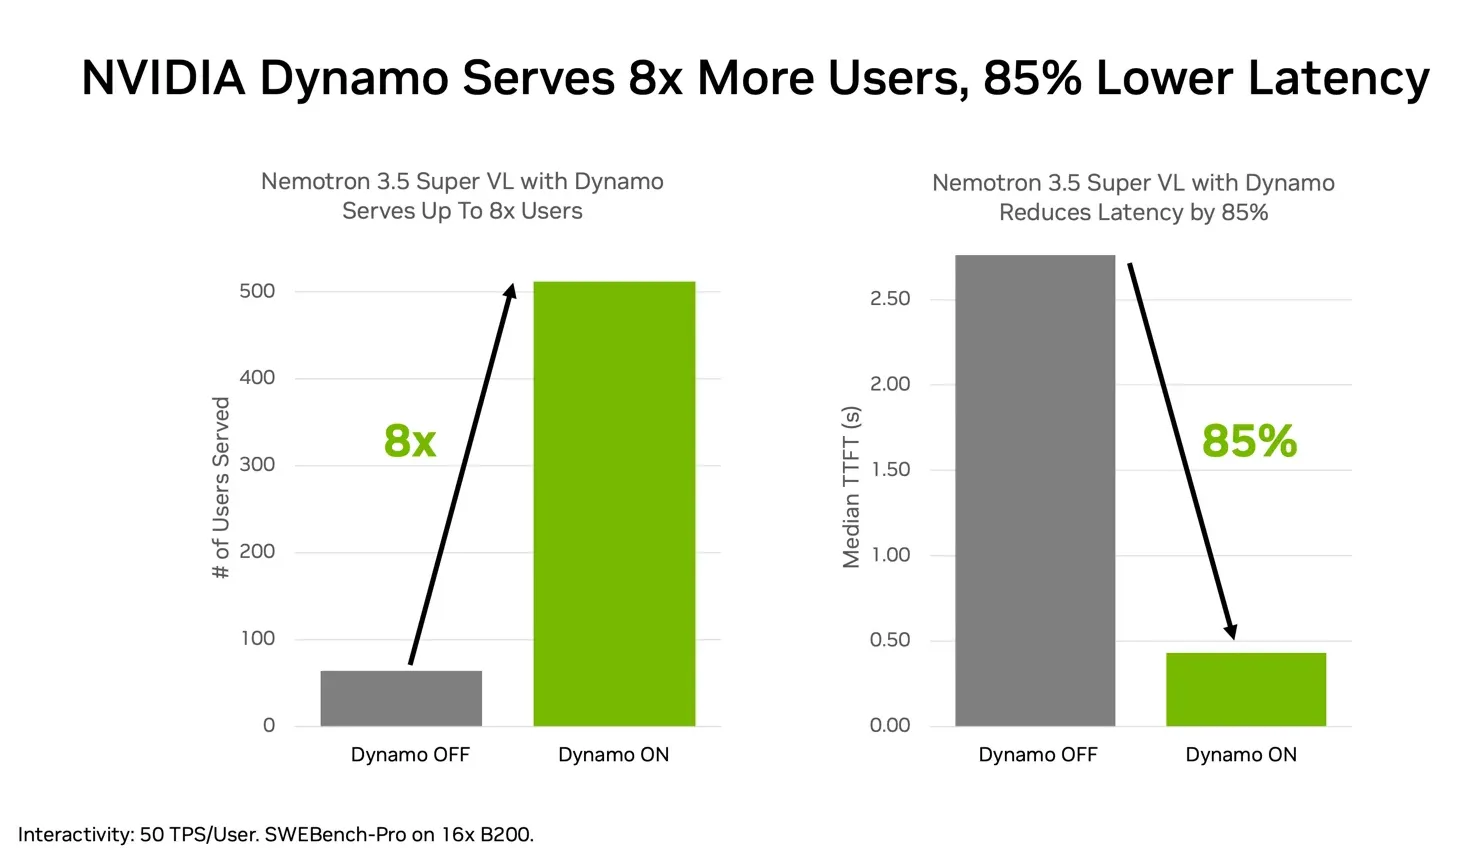 Graphique NVIDIA des gains de Dynamo sur le nombre d'utilisateurs et la latence
Le contexte
Super VL arrive dans une famille que NVIDIA a étoffée en sept mois. D'après 3DNews, Nemotron 3 Super (120 milliards de paramètres) est sorti en mars, Nemotron 3 Nano Omni (30 milliards, texte, image, audio et vidéo) en avril, puis Ultra. Lightning, pour les étapes répétitives des longs flux d'agents, date d'août. Le blog technique de NVIDIA décrit une répartition des rôles : Lightning pour le texte à fort volume, Ultra pour la planification complexe, Super VL pour le travail spécialisé qui demande raisonnement, outils et lecture d'images.
Le message adressé aux entreprises tient en une phrase du communiqué : contrairement aux modèles fermés de pointe, Super VL peut être post-entraîné sur les données de l'organisation, déployé sur sa propre infrastructure, sous son contrôle. Le site français Le Fil IA, qui a relayé l'annonce, y voit un argument de souveraineté pour les entreprises européennes.
Le graphique de post-entraînement de NVIDIA compare des versions spécialisées de Super VL à des modèles fermés. D'après 3DNews, la version adaptée à des demandes d'assurance santé passe d'environ 28 % à 72 % de précision, contre 38 % pour Claude Opus 5, et la robustesse aux cyberattaques de 35 % à 76 %, contre 66 % pour GPT-6.1 Sol. 3DNews prévient que ces versions sont réglées pour des tâches étroites et qu'on ne peut pas en conclure que le modèle de base bat les modèles de pointe.
Ce que ça change
- Un nom qui range la gamme. Lightning, Super, Ultra, puis Bolt : chaque nom annonce un emploi, et les Bolt portent leur contrainte de mémoire dans le nom (24GB, 4GB). Un acheteur sait en lisant la gamme quel modèle va où. Pour une marque tech, c'est une leçon de nommage : un chiffre utile dans le nom vaut mieux qu'un adjectif.
- Le client nommé comme preuve. Skydance, EY, Ramp, Hebbia ou Salesforce apparaissent dans le communiqué avec une tâche précise à chaque fois. La preuve vient d'usages identifiables plutôt que d'un score abstrait. Une agence qui rédige un cas client y trouve un modèle de récit : un nom, un problème, un chiffre avant et après, tous attribués à l'éditeur.
- L'ouverture comme promesse de contrôle. NVIDIA ne vante pas la liberté en général. Elle promet de garder ses données, de choisir où tourne le modèle et de l'adapter. C'est la grille de lecture à reprendre quand une marque annonce un produit « ouvert » : demander ce que l'acheteur peut faire concrètement qu'il ne pouvait pas faire avant.
Ailleurs
Modèle à poids ouverts de 30 milliards de paramètres dont 3 actifs, avec une fenêtre de 1 million de tokens, proposé gratuitement sur AI Gateway de Vercel. Même famille, même logique : un modèle dont le rôle est dans le nom, et une distribution là où les développeurs sont déjà.
Sorti en avril d'après 3DNews, ce modèle de 30 milliards de paramètres réunissait texte, image, audio et vidéo. Super VL reprend l'idée à l'échelle d'un modèle de la gamme Super.
Sources
- NVIDIA Blog : Open From Data Center to Desktop: NVIDIA Expands Nemotron Family With Highest Efficiency Super VL and Bolt Models US, 15 octobre 2026
- NVIDIA Blog France : Du centre de données au poste de travail, une ouverture totale : NVIDIA enrichit la famille Nemotron avec les modèles Super VL et Bolt FR, 15 octobre 2026
- NVIDIA Technical Blog : NVIDIA Nemotron 3.5 Super VL Powers Specialized Agents with Multimodal Reasoning US, 15 octobre 2026
- The Decoder : Nvidia's Nemotron 3.5 Super VL is an open model built to run enterprise AI agents nonstop DE, 15 octobre 2026
- 3DNews : ИИ-модель Nvidia Nemotron 3.5 Super VL с пост-обучением превзошла Claude Opus 5 и GPT-6.1 Sol в специализированных задачах RU, 16 octobre 2026
Cités dans l’article
Réagir
Les réponses des lecteurs
À propos de « NVIDIA ouvre Nemotron 3.5 Super VL »
Pas encore de réponse publiée. Les réponses s’ouvriront ici, relues par la rédaction.
Rien n’est envoyé tant que vous n’appuyez pas sur Envoyer